AI一线|ShareCentre
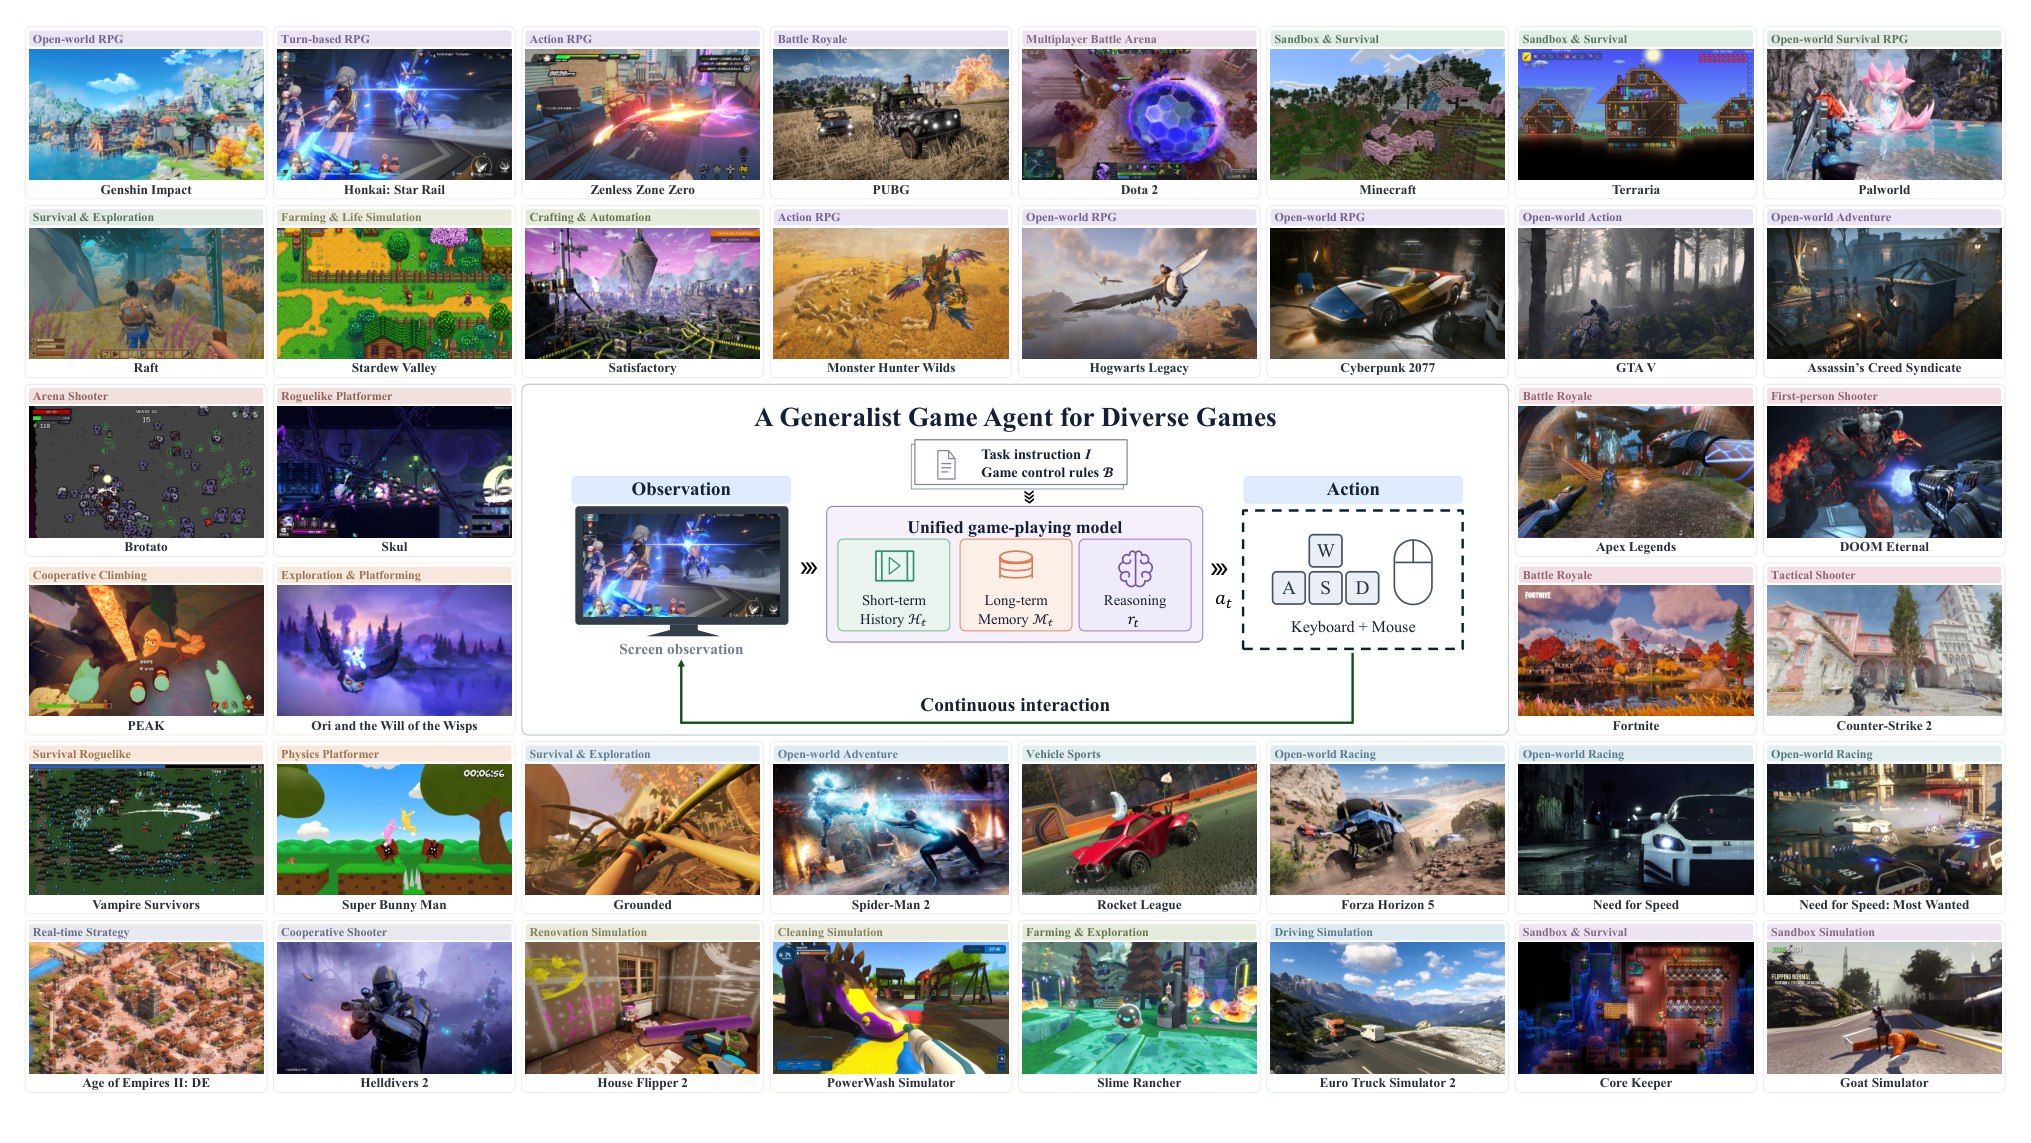
米哈游公布Gamer游戏智能体研究,结合长期记忆与实时键鼠控制 米哈游崩坏AI研发团队公开Gamer研究,以Qwen3-VL-8B为基础,让模型读取游戏画面并输出键盘、鼠标操作。训练依次结合跨游戏预训练、稀疏推理指令训练和TA-GRPO强化学习,目标是持续完成需要导航、交互与解谜的长任务。 系统每秒观察5次,每次规划六段约33毫秒的按键操作,形成约30Hz控制。模型在关键决策时推理,通过摘要记住已完成目标、失败尝试和后续计划;推理引擎复用KV缓存,并在首段动作通过检查后提前交给客户端执行。 作者在《崩坏:星穹铁道》40个测试任务、七类小游戏上报告,强化学习后的宏平均成功率为49.7%,指令训练版为39.2%,提升10.5个百分点。算法先统计每类成功率,再给七类相同权重。模型训练见过同一游戏,测试任务及目标完成过程单独保留。 两个支线各含30和55个里程碑、每项测试三次,强化学习版按里程碑汇